Elinizde yüzlerce PDF fatura, sözleşme ya da form var. Hepsindeki rakamları, tarihleri ve isimleri tek tek Excel'e mi yazıyorsunuz? PDF'den veri çıkarma işini artık yapay zekâya bırakmak mümkün, hem de çoğu zaman aynı günün içinde kurulabilecek kadar basit bir şekilde.
Bu yazıda bu işin nasıl çalıştığını, günlük hayattan örneklerle anlatıyoruz. Teknik bilgiye ihtiyacınız yok; sadece elinizde hangi belgelerin biriktiğini bilmeniz yeterli.
PDF'den Veri Çıkarmak Neden Bu Kadar Zor?
Bir PDF, bilgisayar için aslında bir fotoğraf gibidir. İçindeki yazıyı "görür" ama ne anlama geldiğini bilmez.
Siz bir faturaya bakınca tutarın nerede olduğunu hemen anlarsınız. Bilgisayar için bu hiç kolay değildir; sayılarla harfleri kendi başına ayırt edemez, ikisini de sadece siyah leke olarak görür.
Üstelik her şirketin fatura şablonu farklıdır. Biri tutarı sağ üstte yazar, bir başkası sol altta. Bir çalışan elle veri girerken bu farkı hiç sorun etmez, ama klasik bir bilgisayar programı her yeni şablonda şaşırıp kalır.
Buna el yazısı notlar, damgalar ve imzalar da eklenince iş daha da karışır. Eski yazılımlar burada genelde tamamen pes eder.
Yapay Zekâ Bu İşi Nasıl Yapıyor?
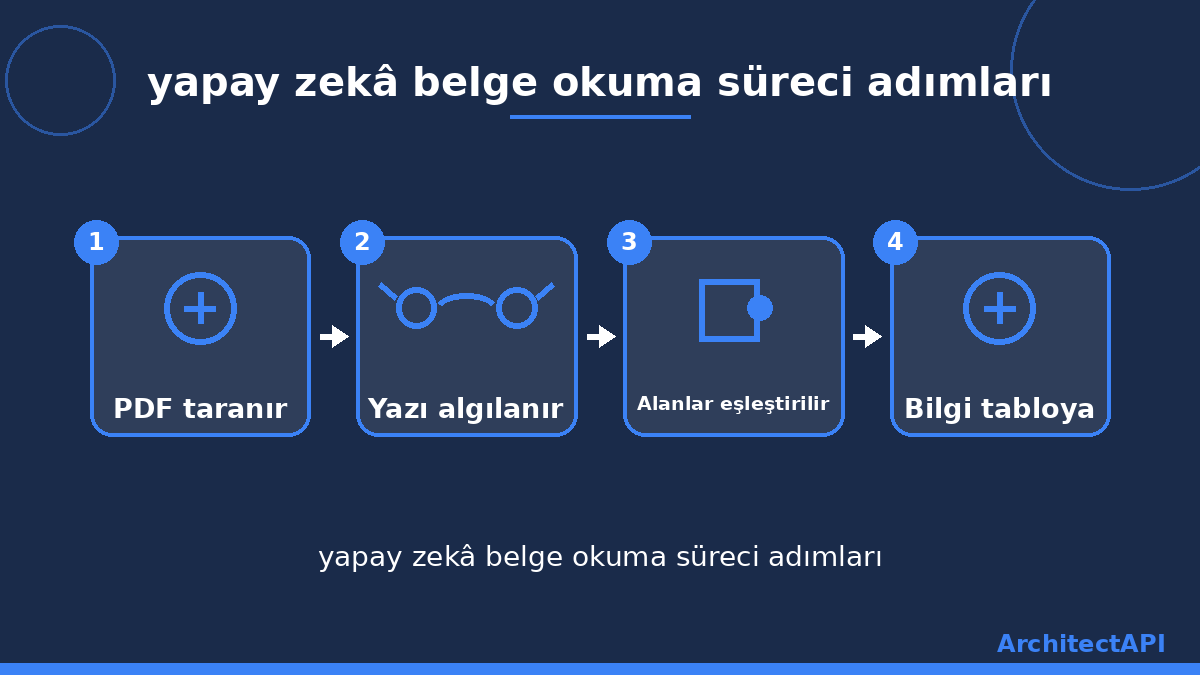
Yapay zekâ önce belgeye bir gözlük takar gibi bakar. Bu adıma OCR denir; bilgisayarın harfleri ve sayıları tanıması demektir.
Sonra ikinci, daha önemli bir adım devreye girer. Yapay zekâ metni okumakla kalmaz, hangi kısmın "tarih", hangisinin "tutar" ya da "müşteri adı" olduğunu da anlar.
Bu, deneyimli bir muhasebe çalışanının yaptığı işe çok benzer. Fark, yapay zekânın bunu saniyeler içinde, yorulmadan ve gece gündüz fark etmeden yapmasıdır.
Sistem her alan için bir de "emin olma oranı" hesaplar. Emin olamadığı bir satır varsa, bunu otomatik onaylamaz; kontrol için bir kişiye gösterir.
Sonuç, düzenli bir tabloya dönüşür. PDF Excel dönüştürme işlemi böylece elle tek bir tuşa dokunmadan tamamlanır.
Hangi Belgelerde Kullanılır?
Bu yöntem sadece faturalarla sınırlı değil. Sözleşmeler, siparişler, formlar, bordrolar ve raporlar da aynı şekilde okunabilir.
Bir inşaat şirketi teklif dosyalarındaki miktarları çıkarabilir. Bir hukuk bürosu sözleşmedeki tarihleri ve tarafları otomatik yakalayabilir.
Bir muhasebe ekibi yüzlerce faturayı tek tek açmadan, saniyeler içinde tabloya aktarabilir. Bir İK ekibi ise yüzlerce özgeçmişten deneyim ve eğitim bilgisini otomatik çıkarabilir. OCR veri çıkarma artık sektör fark etmeden kullanılıyor.
ArchitectAPI'nin belge işleme çözümü tam olarak bu ihtiyaç için tasarlandı; şirketinizin kendi belge şablonlarına göre ayarlanabiliyor.
Elle Çalışmaktan Farkı Ne?
Elle veri girişinde bir çalışan her belgeyi tek tek açar. Okur, not alır, sonra Excel'e geçirir. Yüz belgelik bir yığın bazen günün tamamını alabilir.
Yapay zekâ ile aynı iş çok daha hızlı biter. Yüzlerce belge aynı anda işlenebilir, hata oranı da düşer çünkü yorgunluk ya da dikkat dağınıklığı yoktur.
Üstelik çıkan veri doğrudan muhasebe ya da stok sistemine aktarılabilir. Bu sayede belge işleme yapay zekâ çözümleri, ekibin zamanını gerçek işe ayırmasını sağlar; kimse artık sadece veri kopyalamakla günü geçirmez.
Veri Güvenliği Ne Olacak?
Bu noktada akla hemen bir soru gelir: belgelerdeki hassas bilgiler güvende mi? Modern sistemler bu belgeleri şifreli şekilde işler ve sadece yetkili kişiler sonuçlara erişebilir.
Önemli bir ayrıntı daha var. İyi kurulmuş bir sistemde, kritik ya da şüpheli bir kayıt otomatik olarak onaylanmaz; bir insanın son bakışından geçer. Bu da hem güvenliği hem doğruluğu korur.
Nereden Başlamalı?
Önce hangi belge türünün en çok zaman aldığını belirleyin. Genelde fatura, sözleşme ya da form öne çıkar; ekibinize hangisinin en çok şikayet edildiğini sormak bile yeterli bir başlangıç olabilir.
Sonra bu belgelerden birkaç örnek toplayın. Bir yapay zekâ çözümü bu örneklerle hızla uyum sağlar ve sizin şablonunuzu kısa sürede öğrenir; genelde onlarca örneğe bile ihtiyaç kalmaz.
ArchitectAPI'nin yapay zekâ çözümleri sayfasına göz atarak işletmeniz için uygun seçeneği keşfedebilirsiniz. Ekip, kurulum sürecinde yanınızda olur ve mevcut sisteminize nasıl bağlanacağını birlikte planlarsınız.
Belge yığınlarıyla uğraşmak yerine, bu süreci otomatikleştirip zamanınızı asıl işinize ayırabilirsiniz. Teknolojinin arka planını merak edenler, IBM'in belge işleme yapay zekâsı üzerine hazırladığı rehbere göz atabilir.